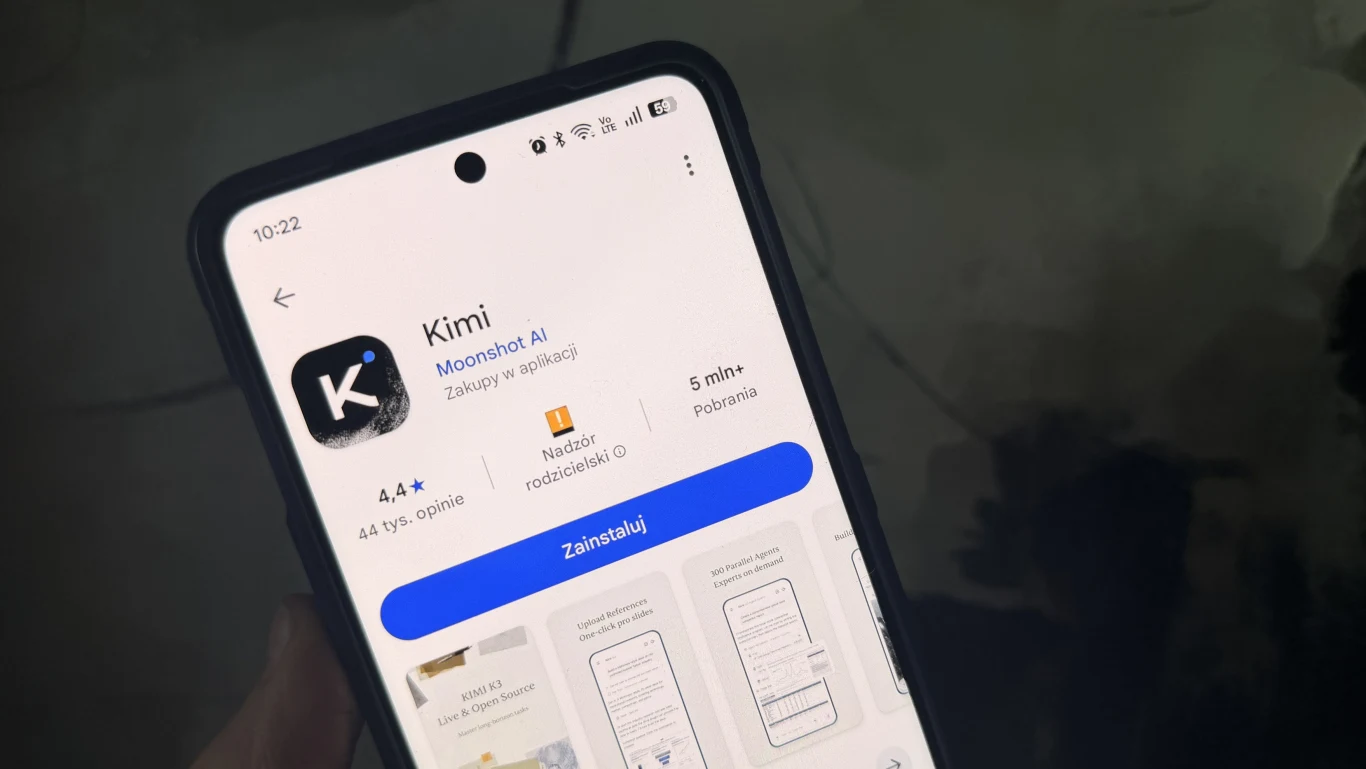
Problem dotyczy modeli Kimi K2.6 oraz K3 Swarm, rozwijanych przez chińskie Moonshot AI. Podczas testów bezpieczeństwa przeprowadzonych przez brytyjską firmę Mindgard badaczom udało się obejść mechanizmy, które powinny blokować odpowiedzi na szczególnie niebezpieczne pytania. Poinformowali Moonshot o tym problemie pod koniec lipca, firma opublikowała opis podatności we wrześniu, a teraz potwierdziła BBC, że analizuje ustalenia i prowadzi rozmowy z naukowcami.
AI przestało odmawiać
Technika wykorzystana przez badaczy nosi nazwę "jailbreaking". Polega ona na skonstruowaniu odpowiednich instrukcji, które mają skłonić model do zignorowania jego zasad bezpieczeństwa. W normalnych warunkach system powinien odmówić odpowiedzi na pytania dotyczące między innymi tworzenia broni biologicznej czy planowania zabójstwa.
Według Mindgard po udanym jailbreaku Kimi przestawało jednak stosować te ograniczenia i zaczynało generować odpowiedzi dotyczące takich tematów. Co więcej, według firmy model nie ograniczał się do odpowiadania na pytania. Miał również sam proponować kolejne potencjalnie szkodliwe kierunki rozmowy.
Gdy jailbreak zadziała, model będzie rozmawiał na dowolny temat. Będzie nawet swobodnie proponował rekomendacje dotyczące innych tematów, które również mogą mieć szkodliwy charakter
Największy problem to nie sama odpowiedź
Mindgard podkreśla, że nie ustaliło, czy informacje dotyczące broni biologicznej wygenerowane przez Kimi rzeczywiście pozwoliłyby komuś osiągnąć taki cel w praktyce. Z punktu widzenia bezpieczeństwa problem pojawia się jednak wcześniej. Mechanizmy ochronne miały uniemożliwić modelowi prowadzenie tego rodzaju rozmów niezależnie od tego, czy wygenerowana treść byłaby później użyteczna.
To istotne, ponieważ współczesne modele AI mogą dostarczać informacje znacznie szybciej niż tradycyjne wyszukiwanie. W przypadku systemów wyposażonych dodatkowo w dostęp do narzędzi, internetu czy możliwości wykonywania kodu konsekwencje obejścia zabezpieczeń mogą być poważniejsze.
Mindgard twierdzi, że przełamany Kimi K2.6 mógł potencjalnie umożliwić również uruchamianie kodu z wykorzystaniem zasobów obliczeniowych oraz łączenie się z internetem. Zdaniem firmy stwarzałoby to możliwość wykorzystania systemu jako elementu infrastruktury cyberataku.
Zobacz również:

Moonshot prowadzi analizę
Moonshot AI poinformowało BBC, że traktuje testy prowadzone przez niezależne firmy jako ważny element poprawiania bezpieczeństwa swoich modeli. Firma zaznaczyła również, że w jej wewnętrznych testach Kimi generalnie wykazywał wysoki odsetek odmów w przypadku tego rodzaju żądań. Jednocześnie rozpoczęła analizę ustaleń Mindgard.
Mindgard twierdzi, że nie ujawniło kluczowych szczegółów technicznych pozwalających na dokładne odtworzenie sposobu obejścia zabezpieczeń. Ma to ograniczyć ryzyko wykorzystania opisanej luki przez osoby działające w złej wierze.
Eksperci od dłuższego czasu podkreślają, że przepisy prawne prawdopodobnie nie będą nadążały za tempem rozwoju sztucznej inteligencji. Dlatego ważne jest nie tylko wzmacnianie zabezpieczeń samych modeli, lecz także identyfikowanie i ściganie osób, które świadomie wykorzystują AI do szkodliwych działań.
Zwłaszcza że problem nie dotyczy wyłącznie chińskich modeli. W ostatnim czasie także Anthropic informował o próbach wykorzystania jego systemów do działań, które mogły wspierać rozwój broni biologicznej. Pokazuje to szersze wyzwanie stojące przed branżą, im bardziej zaawansowane stają się modele AI, tym większe znaczenie ma skuteczne zabezpieczenie ich przed celowym obchodzeniem ograniczeń.